
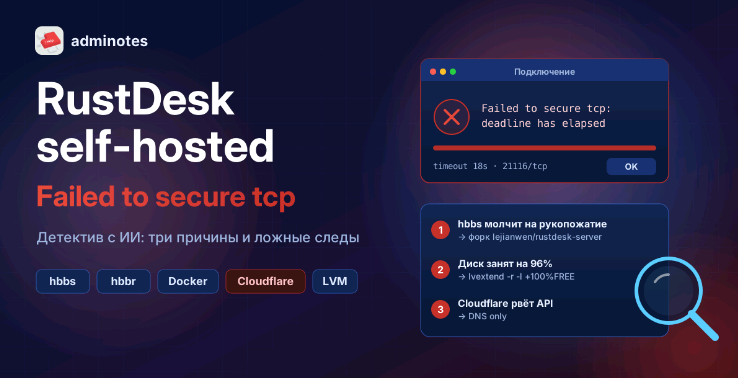
Задача была простая: поднять свой RustDesk для поддержки нескольких организаций — замену TeamViewer с адресной книгой, неконтролируемым доступом и повышением прав. Сервер поднялся за вечер, клиенты в консоли горели зелёным, а подключиться не мог никто. Клиент ждал 18 секунд и выдавал Failed to secure tcp: deadline has elapsed.
Разбирались мы вдвоём: я и Claude, который сидел на сервере по SSH, читал логи и проверял гипотезы. В итоге причин оказалось три, и все независимые. Ни одна из них не была той, на которую я грешил с самого начала. Ниже — весь путь, включая ложные следы: может, кому-то он сэкономит пару дней.
Место действия
Стенд самый обычный. Виртуалка на VMware с Ubuntu 22.04: 2 ГБ памяти, диск 30 ГБ, всё в Docker, в папке /opt/rustdesk. Сервер стоит за MikroTik, порты проброшены с внешнего адреса.
- hbbs — сервер ID и регистрации, порты 21115–21116 (21116 — TCP и UDP).
- hbbr — релей, порт 21117.
- rustdesk-api от lejianwen — веб-консоль, учётные записи и адресная книга, порт 21114. Снаружи он опубликован по HTTPS через отдельный реверс-прокси (у меня это хост с aaPanel).
- Домены в Cloudflare:
rd.example.ruдля ID и релея,rdapi.example.ruдля API.
Исходный docker-compose.yml выглядел так (переменные с ключом и адресами сокращены):
services:
  hbbs:
    image: rustdesk/rustdesk-server:latest
    command: hbbs -r rd.example.ru
    environment:
      - ALWAYS_USE_RELAY=Y
      - RELAY_SERVER=rd.example.ru
      - PUBLIC_ADDR=203.0.113.10
    volumes:
      - ./data:/root
    network_mode: host
    restart: unless-stopped

  hbbr:
    image: rustdesk/rustdesk-server:latest
    command: hbbr
    volumes:
      - ./data:/root
    network_mode: host
    restart: unless-stopped

  rustdesk-api:
    image: ghcr.io/lejianwen/rustdesk-api:latest
    environment:
      - TZ=Europe/Moscow
      - RUSTDESK_API_RUSTDESK_ID_SERVER=rd.example.ru
      - RUSTDESK_API_RUSTDESK_RELAY_SERVER=rd.example.ru
      - RUSTDESK_API_RUSTDESK_KEY=<публичный ключ>
    volumes:
      - ./api-data:/app/data
    network_mode: host
    restart: unless-stopped
Запомните PUBLIC_ADDR — она ещё всплывёт.
Улика: Failed to secure tcp: deadline has elapsed
Картина на момент, когда я подключил ИИ:
- оба тестовых клиента видны в консоли API как online;
- при подключении клиент думает секунд 18 и падает с
Failed to secure tcp: deadline has elapsed; - в логах hbbr пусто, релей не получает ни одного запроса;
- в логе клиента оператора есть строка
UDP NAT test to 10.0.0.25:21116— локальный адрес сервера.
Последняя строка выглядела как признание. Я решил, что hbbs раздаёт клиентам свой внутренний IP вместо внешнего, а оператор за тем же MikroTik упирается в hairpin NAT. Отсюда и PUBLIC_ADDR в конфиге, и попытки прикрутить флаг -R.
Но не подключался и удалённый клиент, сидящий вообще в другой сети, где никакого hairpin нет. Значит, проблема была шире. С этим и отдал дело ИИ.
Ложные следы
Первым делом Claude прошёлся по моим гипотезам — и ни одна не подтвердилась:
- «hbbs отдаёт локальный IP» — нет. Адрес
10.0.0.25в логе оператора взялся из его же файла hosts, куда я сам когда-то прописал домен сервера. Классика. - Hairpin NAT ни при чём. Удалённый клиент его не видит вообще, а падал с той же ошибкой.
PUBLIC_ADDRне существует. Такой переменной у hbbs нет, он её просто игнорирует. Флаг-R— это адрес rendezvous-сервера, а не «публичный IP».- Ключ
-k _не нужен. hbbs и так берёт ключ изid_ed25519в своей папке.
Мораль простая: прежде чем верить строчке в логе, проверь, откуда она там взялась. А переменные окружения из форумов сверять с документацией.
Причина № 1: официальный hbbs не умеет «secure tcp»
Раскололо дело наблюдение: если на клиенте выйти из аккаунта, подключение по ID и паролю проходит. Вошёл обратно — снова 18 секунд и ошибка. Проверить легко: при входе в файле %AppData%\RustDesk\config\RustDesk_local.toml появляется строка access_token, после выхода она исчезает.
Дальше всё сложилось. Клиент, у которого задан ключ сервера и есть токен аккаунта, перед подключением ждёт от hbbs шифрованное рукопожатие на TCP 21116. Таймаут — те самые 18 секунд. Официальный открытый образ rustdesk/rustdesk-server (у меня был 1.1.16) этого рукопожатия не присылает: Claude подключился к 21116 по TCP, и hbbs просто молчал.
Иными словами, связка «официальный сервер + сторонний API-сервер с аккаунтами» в таком виде не работает. Выход — взять hbbs и hbbr из форка того же автора, что и API: lejianwen/rustdesk-server.
Перед заменой образа — бэкап ключей и баз:
cd /opt/rustdesk
cp docker-compose.yml docker-compose.yml.bak-$(date +%Y%m%d-%H%M)
tar czf backup-$(date +%Y%m%d-%H%M)-data.tar.gz data api-data
chmod 600 backup-*-data.tar.gz
Итоговые сервисы hbbs и hbbr:
  hbbs:
    image: lejianwen/rustdesk-server:latest
    command: hbbs -r rd.example.ru
    environment:
      - ALWAYS_USE_RELAY=Y
    volumes:
      - ./data:/root
    network_mode: host
    restart: unless-stopped

  hbbr:
    image: lejianwen/rustdesk-server:latest
    command: hbbr
    environment:
      - LIMIT_SPEED=32
      - SINGLE_BANDWIDTH=128
    volumes:
      - ./data:/root
    network_mode: host
    restart: unless-stopped
docker compose pull && docker compose up -d
Сразу после переключения hbbs начал отвечать на TCP-подключение рукопожатием в 103 байта. Ключ сервера и база остались прежними, на клиентах ничего перенастраивать не пришлось.
Два нюанса форка:
- Релей режет скорость. У форка по умолчанию
LIMIT_SPEED=4иSINGLE_BANDWIDTH=16Мбит/с — для удалёнки тесновато. Я вернул значения официального образа (32 и 128), в логе hbbr это видно при старте. - Обновляется он отдельно от официального сервера, так что строка «new version is available» в логе — про официальный, не про форк. Старый образ я оставил на неделю на случай отката.
Причина № 2: сервер был всё это время чуть жив
Пока разбирались с рукопожатием, Claude наткнулся в логах hbbs на db.update_pk failed: database or disk is full. Рядом жил старый Zammad, и его PostgreSQL падал с No space left on device.
Разгадка оказалась банальной. Установщик Ubuntu отдал корню только 14 ГБ из 28 ГБ LVM-группы, и корень был заполнен на 96%. А после перезагрузки 15 контейнеров (Zammad с Elasticsearch и его кучей в 1 ГБ) пытались влезть в 2 ГБ памяти: своп и 100% CPU.
Проверяем, сколько места лежит без дела:
df -h /
sudo vgs
Если в VFree есть свободное место — отдаём его корню целиком, файловая система расширяется на лету:
sudo lvextend -r -l +100%FREE /dev/ubuntu-vg/ubuntu-lv
Zammad мне был уже не нужен, и я снёс его целиком — контейнеры, тома и образы. После этого корень стал 28 ГБ и занят на 35%, а из 2 ГБ памяти занято около 360 МБ. RustDesk с API к железу совсем нетребовательны.
Урок: перед тем как лезть в сетевые дебри, стоит глянуть df -h и free -h. Я пропустил, потому что «сервер же свежий».
Причина № 3: Cloudflare рвёт адресную книгу
После форка подключения заработали, но адресная книга у клиентов снаружи то грузилась, то нет. Ошибка клиента:
Failed to parse response ... https://rdapi.example.ru/api/ab/settings ... ConnectionReset (10054)
На стороне сервера всё чисто: API отвечает за миллисекунды, в логах ошибок нет. Зацепкой стали адреса клиентов в логе реверс-прокси: там были сплошь сети Cloudflare (172.71.x, 162.158.x, 104.23.x). Домен API висел в Cloudflare с включённым прокси — тем самым оранжевым облаком.
Проверка с внешнего компьютера: 7 запросов подряд проходят, восьмой виснет. Из России трафик к Cloudflare сейчас нередко тормозится провайдерами, и по симптомам это оно. Доказать на 100% нельзя, но лечение подтвердило диагноз.
Лечение: запись API в Cloudflare переводим в режим DNS only (серое облако). После этого 15 из 15 запросов проходят, а адресная книга грузится и в офисе, и снаружи.
Цена вопроса: реальный IP сервера теперь виден в DNS. Для меня это приемлемо: API и так стоит за реверс-прокси. Записи ID и релея, кстати, изначально должны быть DNS only — через прокси Cloudflare порты 21115–21117 не пройдут вообще.
Что пробовали и отбросили
- WebSocket в клиенте. В настройках RustDesk есть галочка «Использовать WebSocket», тогда клиент ходит на
wss://домен/ws/idи/ws/relay. Маршруты в nginx мы добавили, nginx честно отвечал 101. Но открытый hbbs клиента через WebSocket не регистрирует: вечное «Connecting to the RustDesk network…» и «offline» при подключении. Галочку держим выключенной. - RustDesk Server Pro. Платная версия с аккаунтами из коробки решила бы проблему № 1, но форк справился бесплатно.
- Проброс 443 напрямую на сервер RustDesk в обход реверс-прокси. Отказался сам: API должен сидеть за прокси, а не торчать в интернет.
И ещё одно: пробросы 21118/21119 нужны только веб-клиенту и WebSocket. Для обычных клиентов их можно закрыть, а вот 21115 по TCP оставляем — там живёт NAT-тест hbbs.
Как работалось с ИИ
Разбирались через мой Claude-хаб в Telegram (как он устроен — в статье про Claude в Telegram на своём VPS). Начал в браузере, перенёс разговор в телефон и дальше скидывал боту логи клиентов и скриншоты ошибок.
Для доступа к серверу я выдал временный SSH-ключ и отдельный проброс на MikroTik, разрешённый только с IP хаба. Дальше Claude сам:
- читал логи hbbs, hbbr, API и nginx, сверял их с логами клиентов;
- стучался в 21116 и смотрел, отвечает ли hbbs рукопожатием;
- делал бэкапы перед каждой правкой и сразу писал команду отката;
- расширил диск и чистил Docker — после моего «да».
Чего он делать не мог. Скачать и запустить сторонний образ ему запрещали права, форк я запускал сам. Править nginx под root тоже осталось мне. И честности ради: один раз он ошибся, приняв пустой том Docker за мусор. Том оказался подключён к соседнему контейнеру, ошибку он сам же и поймал до удаления. Вывод: ничего необратимого без подтверждения.
В конце он отозвал свой ключ из authorized_keys, проверил, что вход закрыт, и написал итог: что сделано, как откатить, что осталось убрать руками. Из этого итога статья, собственно, и выросла. С момента, как я отдал задачу ИИ, до работающего подключения прошло около пяти часов.
Чеклист: если RustDesk self-hosted не подключается
- Ресурсы.
df -hиfree -h. Полный диск ломает базу hbbs молча, редкой строчкой в логе. - Аккаунт на клиенте. Выйдите из аккаунта и попробуйте по ID и паролю. Заработало — ваш hbbs не умеет secure tcp, нужен форк
lejianwen/rustdesk-serverили Server Pro. - hosts на клиенте. Адрес в логе мог прийти оттуда, а не от сервера.
- Cloudflare. Домены ID и релея — только DNS only. Домен API из России тоже лучше без прокси, иначе адресная книга падает с
ConnectionReset (10054). - Порты. 21115 TCP, 21116 TCP+UDP, 21117 TCP. 21118–21119 — только для веб-клиента.
- WebSocket на клиентах с открытым hbbs — выключен.
- Переменные из интернета сверяйте с документацией:
PUBLIC_ADDRу hbbs не существует.
Сейчас всё работает: с аккаунтом и без, в офисе и снаружи, адресная книга грузится. Если ваш RustDesk сломан как-то иначе — пишите в комментариях, разберём.